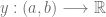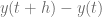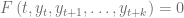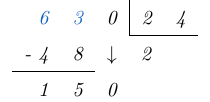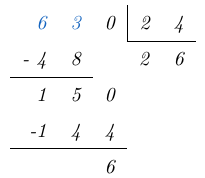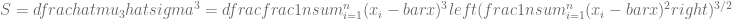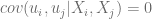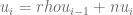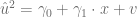
Ecuaciones en Diferencias Finitas

  1. Mediciones continuas y mediciones discretas
    1. Mediciones Continuas
    2. Ejemplos
      1. Ejemplo 1
      2. Ejemplo 2
      3. Ejemplo 3
    3. Mediciones Discretas
    4. Ejemplos
      1. Ejemplo 4
      2. Ejemplo 5
      3. Ejemplo 6
  2. Diferencias finitas
  3. Ecuaciones en Diferencias Finitas
    1. Ejemplos
      1. Ejemplo 7
      2. Ejemplo 8
      3. Ejemplo 9
      4. Ejemplo 10

Las Ecuaciones Diferenciales permiten estudiar distintos fenómenos a través del tiempo de forma continua usando diferenciales, sin embargo, no siempre los fenómenos que se estudian están medidos de forma continua y en cambio, están medidos de forma discreta.

Las Ecuaciones en Diferencias Finitas permiten estudiar distintos fenómenos a través del tiempo de forma discreta usando diferencias, es decir, considerando las relaciones entre dos eventos de un determinado fenómeno cuya información se ha recolectado a través del tiempo.

También pudiera interesarte

Antes de abordar las Ecuaciones en Diferencias Finitas es importante identificar algunos elementos matemáticos que darán precisión a las definiciones que darán cuerpo a la teoría y uno de los elementos más básicos es entender a qué nos referimos cuando se menciona la palabra continua o la palabra discreta.

Mediciones continuas y mediciones discretas

En el ámbito de las Ecuaciones en Diferencias, las variables están medidas a través del tiempo. Usualmente, el tiempo se identifica con la variable t y este puede ser considerado de dos formas.

Mediciones Continuas

Una variable es medida de forma continua si los intervalos de tiempo considerados son muy pequeños (relativo al fenómeno en cuestión), usualmente; segundos, microsegundos o milisegundos. Entonces, una variable y está medida de forma continua si su dominio está definido como un intervalo en el conjunto de los números reales, formalmente, diremos que definida de la siguiente forma:

y : (a,b) \longrightarrow \mathbb{R}

Consideremos en los siguientes ejemplos, fenómenos que han sido medidos de forma continua.

Ejemplos

Ejemplo 1

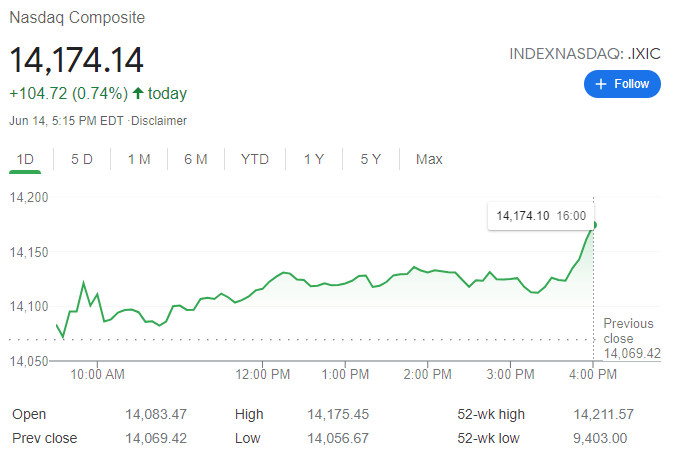
El precio de las acciones en la bolsa de valores está medido de forma continua a través del tiempo, más aún, está medido en tiempo real.
Ejemplo 2

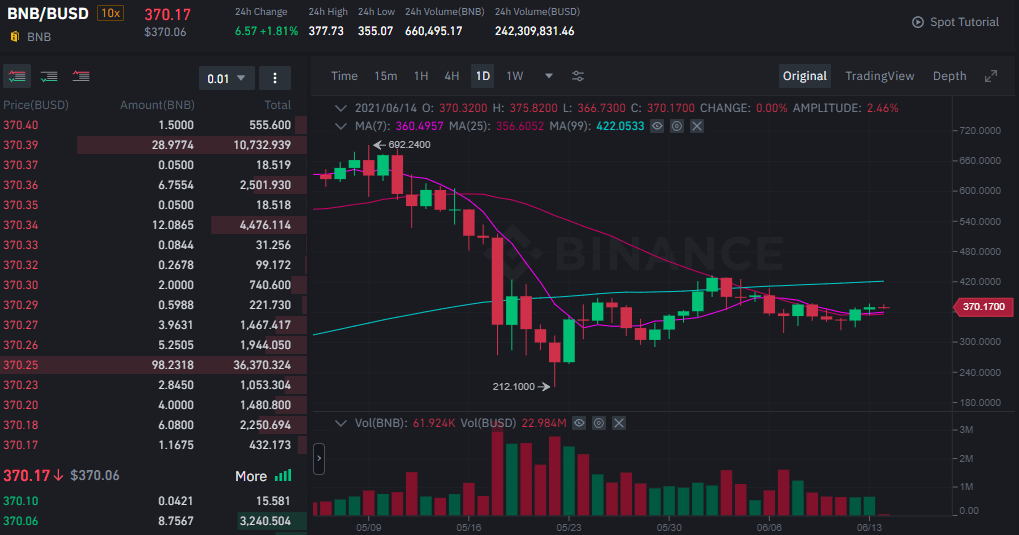
El valor de una criptomoneda está medido de forma continua a través del tiempo, más aún, está medido en tiempo real.
Ejemplo 3

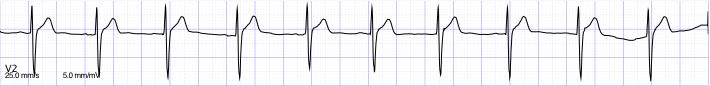
Si una persona está conectada a un electrocardiógrafo para hacer un registro de sus signos vitales, los resultados reflejados en el electrocardiograma están medidos de forma continua a través del tiempo.
Mediciones Discretas

Una variable es medida de forma discreta si los intervalos de tiempo considerados son grandes (relativo al fenómeno en cuestión), usualmente; días, semanas, meses o años. Entonces, una variable y está medida de forma discreta si su dominio está definido por números enteros no negativos, formalmente, diremos que definida de la siguiente forma:

y : \{ 0, 1, 2, \ldots, n \} \longrightarrow \mathbb{R}

Ejemplos

Ejemplo 4

Un censo poblacional es efectuado cada diez años y para mantener estándares internacionales, se recomienda en los años terminados en cero, sin embargo, algunos países los miden cada cuatro años.

Ejemplo 5

La medición de intereses sobre un préstamo o una inversión, usualmente se hace de forma anual, aunque también puede ocurrir de forma trimestral o mensual.

Ejemplo 6

El precio del petróleo se mide de forma diaria, tomando en cuenta que la cesta de la OPEP, que es un promedio de los precios de los petróleos producidos por los países miembros de la OPEP y se utiliza como punto de referencia para los precios del petróleo.

Diferencias finitas

Si consideramos una variable y que depende de una variable t, definimos una diferencia finita de y como una expresión de la forma y(t+b) - y(t+a) para cualesquiera dos números reales a y b. Nos resultará de particular interés la siguiente diferencia:

y(t+h) - y(t)

En el cálculo infinitesimal, esta diferencia sienta la base para definir la derivada de una función. Sin embargo, nuestro propósito será el de trabajar con variables medidas de forma discreta, es por esto que modificaremos nuestra notación un poco:

  • Adoptamos la notación usada para las sucesiones de números reales, de forma, que el valor y(t) se representa como y_{t}.
  • Sustituimos la letra h por la letra k.

Tomando en cuenta esto, expresaremos la diferencia finita de una variable y medida de forma discreta con la expresión

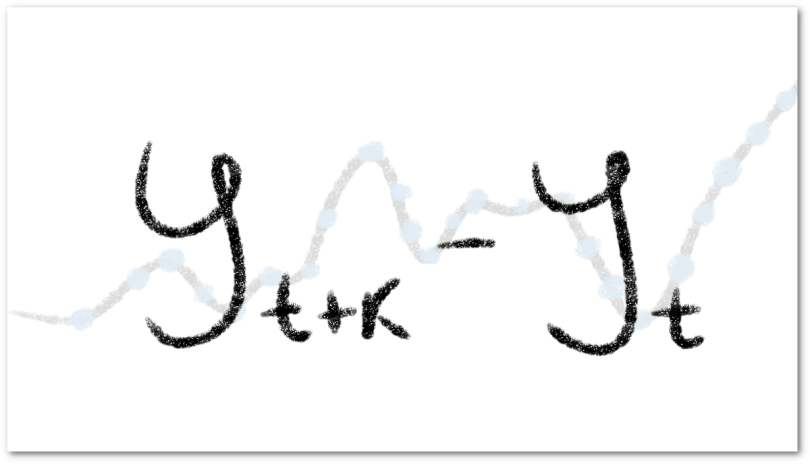
y_{t+k} - y_{t}

A esta última expresión la llamaremos diferencia finita de orden k, esto se debe a que esta es la diferencia entre los índices de y_{t} y y_{t+k}, es decir, t+k - t = k.


Ecuaciones en Diferencias Finitas

Considerando una variable discreta t y una variable real y que depende de t, definimos una Ecuación en Diferencias Finitas como una expresión que establece una relación entre la variable t y los valores y_t, y_{t+1}, \ldots, y_{t+k} a través de una igualdad. Formalmente, una relación expresada de la siguiente forma:
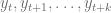
F \left( t,y_t, y_{t+1}, \ldots, y_{t+k} \right)=0

De forma particular, si consideramos la relación y_{t+1} - y_{t} - 5 = 0 diremos que esta es una ecuación en diferencias finitas y nuestro propósito será el de determinar cuál es la forma general de la sucesión y_t que satisface esta igualdad.
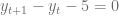
El estudio de las ecuaciones en diferencias finitas tiene su base en el desarrollo de distintas técnicas para hallar la solución de éstas y para lograrlo, debemos clasificarlas. Las ecuaciones en diferencias finitas se clasifican principalmente de dos formas: Por orden y por linealidad.

  • Por linealidad: Una ecuación en diferencias finitas es lineal si ésta es lineal respecto a la variable dependiente.
  • Por orden: El orden de una ecuación en diferencias finitas viene dado por el mayor orden involucrado en ella.
  • Por autonomía:
    • Una ecuación en diferencias finitas es no autónoma o variante en el tiempo si la variable t sí está involucrada como un elemento de la ecuación, es decir, expresada de la forma F \left(t,y_t, y_{t+1}, \ldots, y_{t+k} \right)=0
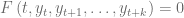
    • Una ecuación en diferencias finitas es autónoma o invariante en el tiempo si la variable t no está involucrada como un elemento de la ecuación, es decir, expresada de la forma F \left(y_t, y_{t+1}, \ldots, y_{t+k} \right)=0

A medida que aprendamos las técnicas para calcular soluciones de ecuaciones en diferencias finitas, veremos otras formas de clasificarlas, por ahora consideremos algunos ejemplos de ecuaciones en diferencias finitas para determinar la clasificación que hemos visto.

Ejemplos

Ejemplo 7

Si consideramos la ecuación en diferencias finitas y_{t+1} - y_{t} - 5 = 0

  • Es lineal ya que el exponente de y_{t+1} y y_{t} es exactamente igual a uno y tampoco hay un producto entre estos dos elementos.
  • Es de primer orden porque la mayor diferencia entre cualquier par de índices involucrados es (t+1)-(t)=1.
  • Es autónoma porque la variable t no aparece involucrada en la ecuación.

Por lo tanto es una Ecuación en Diferencia Finita lineal de primer orden.

Ejemplo 8

Si consideramos la ecuación en diferencias finitas 3y_{t+7} - 9y_{t+3} - 12t = 0
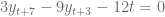
  • Es lineal ya que el exponente de y_{t+7} y y_{t+3} es exactamente igual a uno y tampoco hay un producto entre estos dos elementos.
  • Es de cuarto orden porque la mayor diferencia entre cualquier par de índices involucrados es (t+7)-(t+3)=4.
  • Es no autónoma porque la variable t sí aparece involucrada en la ecuación.

Por lo tanto es una Ecuación en Diferencia Finita lineal de cuarto orden.

Ejemplo 9

Si consideramos la ecuación en diferencias finitas -2ty_{t+5} + 10y_{t+3} + 5y_{t} - 12t^2 + 9 = 0
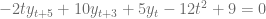
  • Es lineal ya que el exponente de y_{t+5}, y_{t+3} y y_{t} es exactamente igual a uno y tampoco hay un producto entre estos tres elementos.
  • Es de quinto orden porque la mayor diferencia entre cualquier par de índices involucrados es (t+5)-(t)=5.
  • Es no autónoma porque la variable t sí aparece involucrada en la ecuación.

Por lo tanto es una Ecuación en Diferencia Finita lineal de quinto orden.

Ejemplo 10

Si consideramos la ecuación en diferencias finitas 4y_{t+1} \cdot y_{t} - 7 = 0

  • No es lineal, pues existe un producto entre y_{t+1} y y_{t}.
  • Es de primer orden porque la mayor diferencia entre cualquier par de índices involucrados es (t+1)-(t)=1.
  • Es autónoma porque la variable t no aparece involucrada en la ecuación.

Por lo tanto es una Ecuación en Diferencia Finita lineal de primer orden.


Bibliografía Complementaria

Cómo dividir 630÷24

Se ha levantado revuelo en Twitter por un tweet de una persona que no entiende cómo ha sido el procedimiento que ha llevado a cabo su hija para efectuar la operación 630÷24. A mi parecer, ambos procedimientos son iguales, salvo que en el primero se han hecho algunas cuentas mentales y en el segundo ha sido más detallado.

Considerando que en muchas de las respuestas indican que no saben efectuar esa división y aunque no veo ningún problema con eso, para los curiosos, comparto con detalle cual fue el procedimiento que ha usado la hija y veremos que ambos procedimientos expuestos son el mismo.

También pudiera interesarte

Para empezar, debemos notar que la división 630÷24 se conoce como una división entre dos cifras, esto se debe a que el número 24 cuenta con dos cifras. Antes de empezar con el procedimiento para efectuar esta división, veamos con algunos ejemplos como dividir por un número de una cifra.

Ejemplos

Ejemplo 1

Si dividimos 13 entre 5, entonces buscamos un número entero tal que al multiplicarlo por 5 el resultado sea exactamente igual a 13, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 13.

Particularmente el número que estamos buscando es 2 pues 2 \cdot 5 = 10 y de acuerdo con el algoritmo de la división, el resto es igual a 13 - 10 = 3, esto lo expresamos de la siguiente forma:

División de Números Enteros | totumat.com

Como el resto 3 es menor que el divisor 5, ha concluido el procedimiento y decimos que 13 = 2 \cdot 5 + 3. En este caso el resto es distinto de cero, por lo tanto, decimos que la división no es exacta.

Ejemplo 2

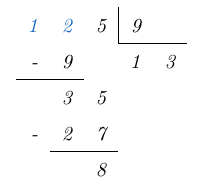
Si dividimos 125 entre 9, pudiéramos buscar un número entero tal que al multiplicarlo por 9 el resultado sea exactamente igual a 125, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 125.

Sin embargo, al ser 125 un número de tres cifras, podemos facilitar las cuentas (aunque alargando el procedimiento) considerando sólo las primeras dos cifras de 125.

Entonces, buscamos un número entero tal que al multiplicarlo por 9 el resultado sea exactamente igual a 12, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 12.

Particularmente el número que estamos buscando es 1 pues 1 \cdot 9 = 9 y de acuerdo con el algoritmo de la división, el resto es igual a 12 - 9 = 3, esto lo expresamos de la siguiente forma:

División de Números Enteros | totumat.com

Una vez que hemos dado este primer paso, bajamos el número 5 y lo escribimos del lado derecho del 3.

División de Números Enteros | totumat.com

Como 35 es mayor que 9, entonces buscamos un número entero tal que al multiplicarlo por 9 el resultado sea exactamente igual a 35, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 35.

Particularmente el número que estamos buscando es 3 pues 3 \cdot 9 = 27 y de acuerdo con el algoritmo de la división, el resto es igual a 35-27 = 8, esto lo expresamos de la siguiente forma:

División de Números Enteros | totumat.com

Como el resto 8 es menor que el divisor 9, ha concluido el procedimiento y decimos que 125 = 13 \cdot 9 + 8. En este caso el resto es distinto de cero, por lo tanto, decimos que la división no es exacta.


Visto un ejemplo de una cifra y teniendo clara la idea de como efectuar una división, veamos qué es lo que ocurre al efectuar la división 630÷24:

630÷24

Si dividimos 630 entre 24, debemos considerar que el número 24 tiene dos cifras. Pudiéramos buscar un número entero tal que al multiplicarlo por 24 el resultado sea exactamente igual a 630, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 630.

Sin embargo, al ser 630 un número de tres cifras, podemos facilitar las cuentas (aunque alargando el procedimiento) considerando sólo las primeras dos cifras de 630.

Entonces, buscamos un número entero tal que al multiplicarlo por 24 el resultado sea exactamente igual a 63, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 63.

Particularmente el número que estamos buscando es 2 pues 2 \cdot 24 = 48 y de acuerdo con el algoritmo de la división, el resto es igual a 63 - 48 = 15, esto lo expresamos de la siguiente forma:
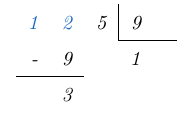
División de Números Enteros | totumat.com

Una vez que hemos dado este primer paso, bajamos el número 0 y lo escribimos del lado derecho del 15.

División de Números Enteros | totumat.com

Como 150 es mayor que 24, buscamos un número entero tal que al multiplicarlo por 24 el resultado sea exactamente igual a 150, pero si no existe este número, buscamos un resultado que esté lo más cercano posible pero menor que 150.

Notemos que 150 es un número de tres cifras, pero si consideramos sólo las primeras dos cifras, no podemos continuar con el procedimiento pues 15 es menor que 24.

Particularmente el número que estamos buscando es 6 pues 6 \cdot 24 = 144 y de acuerdo con el algoritmo de la división, el resto es igual a 150-144 = 6, esto lo expresamos de la siguiente forma:
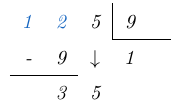
División de Números Enteros | totumat.com

Como el resto 6 es menor que el divisor 24, ha concluido el procedimiento y decimos que 125 = 13 \cdot 9 + 3. En este caso el resto es distinto de cero, por lo tanto, decimos que la división no es exacta.

Análisis de Residuos

R: Normalidad de los Residuos

Estudiar el comportamiento de los residuos u_i = Y_i - \hat{Y}_i es de vital importancia para el análisis de regresión, pues varios de los supuestos del Modelo Clásico de Regresión Lineal (MCRL) hacen énfasis en los residuos, es por esto que se recurre a herramientas que nos permitan verificar si se cumplen estos supuestos y así, aumentar la confiabilidad sobre las conclusiones que se hagan a partir del modelo planteado.

También pudiera interesarte

Datos a considerar para los ejemplos

Consideremos un pequeño conjunto de datos, particularmente, los datos que se encuentran en la Tabla 3.2 del libro de Econometría de Damodar N. Gujarati and Dawn Porter en su quinta edición. Este conjunto de datos proporciona los datos primarios que se necesitan para estimar el efecto cuantitativo de la escolaridad en los salarios:

ObservaciónSalarioEscolaridad
14.45676
25.777
35.97878
47.33179
57.318210
66.584411
77.818212
87.835113
911.022314
1010.673815
1110.836116
1213.61517
1313.53118
Tabla 3.2

Normalidad

El modelo clásico de regresión lineal normal supone que cada u_i está normalmente distribuida si

  • Media: E(u_i)=0
  • Varianza: var(u_i) = \sigma^2
  • Covarianza: cov(u_i,u_j) = 0, , i \neq j

Estos supuestos se expresan en forma más compacta como

u_i \sim N(0,\sigma^2)

Donde el símbolo sim significa distribuido, N denota distribución normal y los términos entre paréntesis representan los dos parámetros de la distribución normal: la media y la varianza, respectivamente.

Esta verificación se pude hacer de dos formas: Gráficamente o Estadísticamente.

Gráficamente

Histograma

Podemos graficar un histograma recurriendo a la instrucción hist() para hacer un histograma representando las frecuencias, entonces si previamente hemos definido el modelo lineal usando la instrucción lm() usamos la siguiente sintaxis:

hist(lm(Y~X)$residuals)

Aunque si queremos ver un histograma representando la densidad, incorporamos la opción prob = TRUE en la instrucción hist() y más aún, si queremos representar sobre nuestro histograma la línea de densidad, recurrimos a la instrucción line() en conjunto con la instrucción density() usando la siguiente sintaxis:

hist(lm(Y~X)$residuals,prob = TRUE)
lines(density(lm(Y~X)$residuals))

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos generar un histograma de los residuos usando la siguiente sintaxis:

hist(se.lm$residuals,prob = TRUE)
lines(density(se.lm$residuals))

Al ejecutar esta instrucción obtenemos el gráfico que estamos buscando:

El gráfico de barras que representa el histograma no demuestra de forma concreta una distribución normal y aunque la línea pareciera dibujar una especie de campana con una protuberancia en el lado izquierdo, no podemos hacer una conclusión fehaciente, así que también se deben llevar a cabo pruebas estadísticas.

Normal QQ-Plot

El QQ-Plot se traduce como el Diagrama de Cuantil-Cuantil y es un diagrama de dispersión que permite comparar distribución de probabilidades. Una gráfica Q-Q es una gráfica de dispersión creada al graficar dos conjuntos de cuantiles entre sí. Si ambos conjuntos de cuantiles provienen de la misma distribución, deberíamos ver los puntos formando una línea que es aproximadamente recta.

Es decir, al comparar la distribución de probabilidad normal con la distribución de probabilidad de los residuos de nuestro modelo lineal, si estos forman una línea recta, este es un indicador de que los residuos están distribuidos de forma normal.

Este gráfico se puede generar con usando la instrucción plot() sobre el modelo lineal, que genera cuatro gráficos pero en este caso nos interesará sólo uno de ellos, el 2:

plot(lm(Y~X),2)

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos generar un histograma de los residuos usando la siguiente sintaxis:

plot(lm(salario~escolaridad),2)

Al ejecutar esta instrucción obtenemos el gráfico que estamos buscando:

Aunque no de forma precisa, podemos notar que el diagrama de dispersión pareciera ajustarse a la recta indentidad, representada con una línea punteada, por lo que este gráfico sugiere que sí hay una distribución normal de los residuos. Sin embargo, no podemos hacer una conclusión fehaciente, así que también se deben llevar a cabo pruebas estadísticas.

Estadísticamente

Jarque–Bera test

La Prueba de Jarque-Bera partiendo del hecho de que una distribución normal tiene coeficiente de asimetría igual a 0 y Curtosis igual a 3. Estos dos elementos se miden a partir de los residuos de nuestro modelo lineal usando la siguientes formulas, respectivamente:

S = dfrac{ hat{mu}_3 }{ hat{sigma}^3 } = dfrac{frac1n sum_{i=1}^n (x_i-bar{x})^3} {left(frac1n sum_{i=1}^n (x_i-bar{x})^2 right)^{3/2}} y K = dfrac{ hat{mu}_4 }{ hat{sigma}^4 } = dfrac{frac1n sum_{i=1}^n (x_i-bar{x})^4} {left(frac1n sum_{i=1}^n (x_i-bar{x})^2 right)^{2}}

Definiendo así el coeficiente de asimetría (S) y la curtosis (K), se define el estadístico de Jarque-Bera de la siguiente forma:

mathit{JB} = frac{n}{6} left( S^2 + frac14 (K-3)^2 right)

Si el valor del estadístico es igual a cero, este es un indicador de que la distribución de los residuos es normal. Más aún, El estadístico de Jarque-Bera se distribuye asintóticamente como una distribución chi cuadrado con dos grados de libertad y puede usarse para probar la hipótesis nula de que los datos pertenecen a una distribución normal. La hipótesis nula es una hipótesis conjunta de que la asimetría y el exceso de curtosis son nulos (asimetría = 0 y curtosis = 3)

Para llevar a cabo esta prueba en R, se carga a la librería tseries y en ella recurrimos a la instrucción jarque.bera.test() usando la siguiente sintaxis:

library(tseries)
jarque.bera.test(lm(Y~X)$residuals)

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos llevar a cabo la Prueba de Jarque-Bera, para esto, usamos la siguiente sintaxis:

library(tseries)
jarque.bera.test(se.lm$residuals)

Al ejecutar esta instrucción obtenemos los resultados de la prueba, donde nos interesará de forma particular que el p-value es igual a 0.6608, notando que este valor es mayor que 0.05, entonces no rechazamos la hipótesis nula y podemos asumir que el coeficiente de asimetría es igual a cero y que la curtosis es igual tres, por lo que asumimos que los residuos tienen una distribución normal.

En su consola debería aparecer:

> library(tseries)
> jarque.bera.test(se.lm$residuals)

	Jarque Bera Test

data:  se.lm$residuals
X-squared = 0.8287, df = 2, p-value = 0.6608
Anuncios

Bibliografía complementaria


Observaciones

Las pruebas expuestas en esta lección sirven para hacer algunas aseveraciones y su carácter didáctico es importante para entender el análisis de residuos, sin embargo, Jeffrey Wooldridge en su cuenta de twitter hace algunas observaciones que deben ser consideradas al hacer trabajos más especializados.

Análisis de Residuos

R: No-Autocorrelación de los Residuos

Estudiar el comportamiento de los residuos u_i = Y_i - \hat{Y}_i es de vital importancia para el análisis de regresión, pues varios de los supuestos del Modelo Clásico de Regresión Lineal (MCRL) hacen énfasis en los residuos, es por esto que se recurre a herramientas que nos permitan verificar si se cumplen estos supuestos y así, aumentar la confiabilidad sobre las conclusiones que se hagan a partir del modelo planteado.

También pudiera interesarte

Datos a considerar para los ejemplos

Consideremos un pequeño conjunto de datos, particularmente, los datos que se encuentran en la Tabla 3.2 del libro de Econometría de Damodar N. Gujarati and Dawn Porter en su quinta edición. Este conjunto de datos proporciona los datos primarios que se necesitan para estimar el efecto cuantitativo de la escolaridad en los salarios:

ObservaciónSalarioEscolaridad
14.45676
25.777
35.97878
47.33179
57.318210
66.584411
77.818212
87.835113
911.022314
1010.673815
1110.836116
1213.61517
1313.53118
Tabla 3.2

No-Autocorrelación

Sin consideramos dos valores de la variable independiente X, digamos X_i y X_j con (ineq j), la correlación entre dos u_i y u_j cualesquiera (ineq j) es cero. En pocas palabras, estas observaciones se muestrean de manera independiente. Es decir, se verifica que

cov(u_i, u_j |X_i, X_j)=0 o, si X no es estocástica, cov(u_i, u_j)=0

Esta verificación se pude hacer de dos formas: Gráficamente o Estadísticamente.

Gráficamente

Diagrama de Dispersión

Haciendo diagrama de dispersión recurriendo a la instrucción plot(), entonces si previamente hemos definido el modelo lineal usando la instrucción lm() usamos la siguiente sintaxis:

plot(lm(Y~X)$residuals)

Este gráfico de dispersión se puede generar con mayor detalle usando la instrucción plot() sobre el modelo lineal, que genera cuatro gráficos pero en este caso nos interesarán sólo dos de ellos, el 1 y el 3:

plot(lm(Y~X),1)
plot(lm(Y~X),3)

Un indicador de no autocorrelación es que en el gráfico de dispersión no se presente ningún patrón lineal de comportamiento, en términos coloquiales: deben estar todos a lo loco. Dicho esto, los gráficos de dispersión, sirven principalmente como indicadores pero si no se tiene certeza sobre lo que se observa, lo mejor es llevar a cabo una prueba estadística.

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos generar un diagrama de dispersión de los residuos y de la raíz cuadrada de los residuos estudentizados uno junto al otro combinando la instrucciones par() y plot(), para esto, usamos la siguiente sintaxis:

#par(mfrow = c(1,2))
plot(lm(salario~escolaridad),1)
plot(lm(salario~escolaridad),3)

Al ejecutar esta instrucción obtenemos los gráficos que estamos buscando:

La línea roja es un ajuste local de los residuos (ponderada localmente) que suaviza los puntos del diagrama de dispersión para facilitad la detección patrones en los residuos. Lo que buscamos es que esta línea roja no describa un comportamiento lineal recta creciente ni decreciente.

En este ejemplo, la línea roja no es una línea recta creciente ni decreciente por lo que estos gráficos sugieren que los residuos no presentan autocorrelación. Hay que tomar en cuenta que los gráficos sirven meramente como indicadores, así que también se deben llevar a cabo pruebas estadísticas.

Estadísticamente

Prueba de Durbin-Watson

Para estudiar la autocorrelación de los residuos, es necesario estudiar la autocorrelación para cualesquiera dos u_i y u_j, esta tarea puede resultar tediosa, así que una de las alternativas es aplicar la Durbin-Watson test (Prueba de Durbin-Watson) que originalmente es usada para datos generados a través del tiempo (Series de Tiempo) para observar si existe una tendencia al comparar periodos previos. En este caso se estudia la relación entre los valores separados el uno del otro por un intervalo de tiempo igual a uno (cada elemento, con su anterior), esto es lo que se conoce como el rezago igual a 1.

Considerando una regresión auxiliar para los residuos expresada como una serie de tiempo usando el coeficiente de correlación rho, de la forma:

u_i = rho u_{i-1}+ nu_i

Se plantea la hipótesis nula de que usando el coeficiente de correlación rho = 0 y la hipótesis alternativa es rho neq 0, para probar esta hipótesis se define el siguiente estadístico de prueba:

d = dfrac{sum_{i=2}^n (u_i - u_{i-1})^2}{sum_{i=1}^n u_i^2}

Se denota con la letra d (por Durbin-Watson). Entonces, considerando el coeficiente de correlación muestral de los residuos hat{rho}, el estadístico de prueba d es aproximadamente 2(1-hat{rho}, por lo tanto, si este estadístico de prueba es igual a 2, esto implica que hat{rho} = 0 indicando que no existe correlación (serial) entre los residuos.

Para llevar a cabo esta prueba en R, se carga a la librería lmtest y en ella recurrimos a la instrucción dbtest() usando la siguiente sintaxis:

library(lmtest)
dwtest(lm(Y~X))

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos llevar a cabo la Prueba de Durbin-Watson, para esto, usamos la siguiente sintaxis:

library(lmtest)
dwtest(lm(salario~escolaridad))

Al ejecutar esta instrucción obtenemos los resultados de la prueba, donde nos interesará de forma particular que el p-value es igual a 0.1992, notando que este valor es mayor que 0.05, entonces no rechazamos la hipótesis nula y podemos asumir que los residuos no presentan autocorrelación.

También podemos finarnos en el estadístico de Durbin-Watson, que en este caso es igual a 1.738, que está cercano a 2. Entonces no rechazamos la hipótesis nula y podemos asumir que los residuos no presentan autocorrelación.

En su consola debería aparecer:

> dwtest(lm(salario~escolaridad))
	Durbin-Watson test
data:  lm(salario ~ escolaridad)
DW = 1.738, p-value = 0.1992
alternative hypothesis: true autocorrelation is greater than 0
Anuncios

Bibliografía complementaria


Observaciones

Las pruebas expuestas en esta lección sirven para hacer algunas aseveraciones y su carácter didáctico es importante para entender el análisis de residuos, sin embargo, Jeffrey Wooldridge en su cuenta de twitter hace algunas observaciones que deben ser consideradas al hacer trabajos más especializados.

Análisis de Residuos

R: homocedasticidad de los Residuos

Estudiar el comportamiento de los residuos u_i = Y_i - \hat{Y}_i es de vital importancia para el análisis de regresión, pues varios de los supuestos del Modelo Clásico de Regresión Lineal (MCRL) hacen énfasis en los residuos, es por esto que se recurre a herramientas que nos permitan verificar si se cumplen estos supuestos y así, aumentar la confiabilidad sobre las conclusiones que se hagan a partir del modelo planteado.

También pudiera interesarte

Datos a considerar para los ejemplos

Consideremos un pequeño conjunto de datos, particularmente, los datos que se encuentran en la Tabla 3.2 del libro de Econometría de Damodar N. Gujarati and Dawn Porter en su quinta edición. Este conjunto de datos proporciona los datos primarios que se necesitan para estimar el efecto cuantitativo de la escolaridad en los salarios:

ObservaciónSalarioEscolaridad
14.45676
25.777
35.97878
47.33179
57.318210
66.584411
77.818212
87.835113
911.022314
1010.673815
1110.836116
1213.61517
1313.53118
Tabla 3.2

Homocedasticidad

Para estudiar la homocedasticidad de los residuos o la homogeneidad de la varianza, se estudia qué tan constante es la varianza de los residuos, es decir, se estudia la heterocedasticidad de los residuos y se verifica que esta sea lo más pequeña posible. Para esto, es necesario estudentizar los residuos de la siguiente forma:

\dfrac{u-\overline{u}}{\hat{\sigma}^2}

Posteriormente, comparamos los residuos estudentizados con los valores estimados de la variable dependiente y esto se pude hacer de dos formas: Gráficamente o Estadísticamente.

Gráficamente

Haciendo diagrama de dispersión recurriendo a la instrucción plot(), entonces si previamente hemos definido el modelo lineal usando la instrucción lm() usamos la siguiente sintaxis:

std.res = (lm(Y~X)$residuals-mean(lm(Y~X)$residuals))/sigma2.e
plot(lm(Y~X)$fitted.values,std.res)

En un gráfico donde no haya heterocedasticidad (es decir, que indique homocedasticidad), es necesario que los puntos estén distribuidos de forma aleatoria y repartidos con equidad a través a lo largo del Eje Vertical, es decir, si se traza una recta horizontal en cero, estos no deberían estar acumulados ni por encima ni por debajo de esta recta.

Este gráfico de dispersión se puede generar con mayor detalle usando la instrucción plot() sobre el modelo lineal, que genera cuatro gráficos pero nos interesarán sólo dos de ellos, el 1 y el 3:

plot(lm(Y~X),1)
plot(lm(Y~X),3)

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos generar un diagrama de dispersión de los residuos y de la raíz cuadrada de los residuos estudentizados uno junto al otro combinando la instrucciones par() y plot(), para esto, usamos la siguiente sintaxis:

#par(mfrow = c(1,2))
plot(lm(salario~escolaridad),1)
plot(lm(salario~escolaridad),3)

Al ejecutar esta instrucción obtenemos los gráficos que estamos buscando:

La línea roja es un ajuste local de los residuos (ponderada localmente) que suaviza los puntos del diagrama de dispersión para facilitad la detección patrones en los residuos. La situación ideal es que esta línea roja sea una se asemeje a una recta horizonal centrada en cero.

En este ejemplo, la línea roja no es una recta horizonal centrada en cero pero estos parecieran estar al menos, distribuidos de forma aleatoria. Sin embargo, debido a la poca cantidad de datos, no podemos hacer una conclusión fehaciente.

Estadísticamente

Prueba de Breush-Pagan

La Breush-Pagan Test (Prueba de Breusch–Pagan), parte del hecho que la media de los residuos es igual a cero y si la varianza no depende de la variable independiente, se puede obtener una estimación de esta varianza a partir del promedio de los cuadrados de los residuos.

De esta forma, a partir del contrarrecíproco, se concluye que si esta estimación de la varianza no se puede obtener, entones la varianza está linealmente relacionada con la variable independiente. Para esto se define una regresión lineal auxiliar para el cuadrado de los residuos

\hat{u}^2 = \gamma_0 + \gamma_1 \cdot x + v

Se plantea entonces como hipótesis nula que existe homocedasticidad y como hipótesis alternativa que existe heterocedasticidad. Es una prueba de chi-cuadrado: el estadístico de prueba se distribuye nchi^2 con k grados de libertad. Si el estadístico de prueba tiene un p-value por debajo de un umbral apropiado, entonces se rechaza la hipótesis nula de homocedasticidad y se asume heterocedasticidad.

Para llevar a cabo esta prueba en R, se carga a la librería lmtest y en ella recurrimos a la instrucción bptest() usando la siguiente sintaxis:

library(lmtest)
bptest(lm(Y~X))

También se puede llevar a cabo esta prueba en R, cargando la librería car y en ella recurrimos a la instrucción ncvTest() usando la siguiente sintaxis:

library(car)
ncvTest(lm(Y~X))

Ejemplo

Una vez que hemos calculado el modelo lineal que define este conjunto de datos usando la instrucción lm(), podemos llevar a cabo la Prueba de Breusch–Pagan, para esto, usamos la siguiente sintaxis:

library(lmtest)
bptest(lm(salario~escolaridad))

Al ejecutar esta instrucción obtenemos los resultados de la prueba, donde nos interesará de forma particular que el p-value es igual a 0.3394, notando que este valor es mayor que 0.05, entonces no rechazamos la hipótesis nula y podemos asumir que existe homocedasticidad.

En su consola debería aparecer:

> library(lmtest)
> bptest(lm(salario~escolaridad))

	studentized Breusch-Pagan test

data:  lm(salario ~ escolaridad)
BP = 0.91274, df = 1, p-value = 0.3394
Anuncios

Bibliografía complementaria


Observaciones

Las pruebas expuestas en esta lección sirven para hacer algunas aseveraciones y su carácter didáctico es importante para entender el análisis de residuos, sin embargo, Jeffrey Wooldridge en su cuenta de twitter hace algunas observaciones que deben ser consideradas al hacer trabajos más especializados.